flowchart LR
A[Operador no Streamlit] --> B[Agente ReAct / Gemini]
B --> C{Guardrails de Código}
C -->|Leitura Segura| D[tool_sql_query]
C -->|Matemática Pura| E[tool_analise_risco]
C -->|Trava Financeira| F[tool_gerar_voucher]
C -->|KPIs Consolidados| G[tool_resumo_operacional]
QueryRunner AI: O que aprendi criando um agente para operações
Lições práticas sobre quando usar (e quando não usar) IA em operações críticas.
AI Engineering
Agentes de IA
Python
SQLite
Aprendizados
Co-piloto com Text-to-SQL seguro e guardrails determinísticos para logística urbana.
A adoção de agentes conectados a bancos de dados já vem transformando grandes empresas de tecnologia e logística, onde operadores precisam tomar decisões rápidas sem depender de filas de engenharia de dados. Um dos casos mais emblemáticos é o do DoorDash com a Vera — uma assistente interna baseada em IA e Text-to-SQL. No DoorDash, a Vera ajuda equipes de operações e suporte a investigar corridas, analisar pedidos em tempo real e identificar causas-raiz de falhas logísticas direto nos bancos de dados, reduzindo drasticamente o tempo de diagnóstico em momentos críticos de pico.
Mas quando você senta para construir um agente que precisa lidar com uma base de dados real ou apoiar uma operação crítica, a realidade traz desafios claros: modelos de linguagem podem alucinar números, tentar executar queries inválidas e tomar decisões desordenadas se você não colocar limites rígidos em código.
Aqui conto o contexto do problema, as decisões de arquitetura que tomei e o que aprendi no caminho.
O Problema Real: O estresse de quem opera entregas na rua
Imagine a seguinte cena: final de tarde em São Paulo, cai aquela chuva torrencial típica e dezenas de entregas começam a atrasar ao mesmo tempo.
O supervisor de tráfego (quem fica na mesa de controle monitorando motoristas e pedidos) precisa apagar vários incêndios ao mesmo tempo:
- Ele recebe uma reclamação de corrida atrasada.
- Abre uma ferramenta como DBeaver ou Metabase para digitar SQL na mão e achar o pedido.
- Precisa avaliar no olho se o atraso foi por trânsito, chuva ou problema com o entregador.
- Se for o caso de compensar o cliente, ele abre outro sistema para gerar um voucher financeiro.
Esse processo manual consome facilmente cerca de 5 minutos por ocorrência. Em um dia chuvoso com dezenas de chamados simultâneos, a operação sofre com gargalos significativos.
A minha ideia com o QueryRunner foi simples: criar um assistente onde o operador pudesse perguntar em bom português o que está acontecendo e tomar a decisão em segundos — mas com regras de segurança que impedem a IA de executar comandos destrutivos no banco de dados ou emitir compensações financeiras sem autorização prévia.
O maior aprendizado: Saber onde NÃO colocar IA
A primeira tentação de quem começa a criar agentes é pedir para a LLM fazer tudo no prompt: “analise o risco, calcule a média, veja o atraso e decida o que fazer”.
Isso é a receita para dar errado em produção. LLM é excelente para entender linguagem natural e intenção, mas é péssima para somar números ou seguir regras financeiras estritas.
A divisão que fiz no projeto foi clara:
[Pergunta do Operador] ➔ LLM só entende a intenção e escolhe a ferramenta
                                    │
            ┌───────────────────────┴───────────────────────┐
            ▼                                               ▼
[Regras Determinísticas em Python]                  [Dados no SQLite]
• Score de risco em Python puro                     • Views analíticas pré-computadas
• Trava de voucher > R$ 100 • Consultas SELECT somente-leitura- Cálculo de KPIs e médias: Ficam 100% no SQLite através de uma view analítica (
vw_kpi_operacao). O agente só consulta o número pronto, ele nunca tenta calcular médias na janela de contexto. - Score de Risco (0 a 100): Desenvolvi uma heurística em Python puro (
tool_analise_risco). Ela cruza o tempo decorrido vs. estimado e a gravidade dos incidentes. É matemática pura, determinística e auditável. - O papel da IA: Apenas entender se o usuário quer saber de atrasos, se quer um resumo da operação ou se quer avaliar um pedido específico, chamando a ferramenta certa.
Como o QueryRunner funciona por baixo do capô
O projeto foi construído usando Python, SQLite e uma interface interativa em Streamlit.
1. Guardrails na prática (Three-Tier Boundaries)
Adotei o modelo de fronteiras (Always Do, Ask First, Never Do) proposto por referências de engenharia de software para agentes (como Addy Osmani):
- Sempre faz (Always Do): Responde direto ao ponto no padrão executivo BLUF (Bottom Line Up Front — diagnóstico na primeira frase) e sempre exibe a query SQL executada para que o operador possa conferir o que foi feito.
- Pergunta antes (Ask First / Human-in-the-Loop): Se o operador pedir um voucher de compensação de até R$ 100,00, a ferramenta gera e registra no banco. Se pedir acima de R$ 100,00, o código bloqueia na hora (
requires_approval) e avisa que valores dessa magnitude exigem validação de alçada de um supervisor. - Nunca faz (Never Do): O conector de SQL usa regex para bloquear qualquer comando perigoso (
DROP,DELETE,UPDATE,TRUNCATE). Se alguém tentar “delete os pedidos cancelados”, a resposta é barrada antes mesmo de tocar no banco.
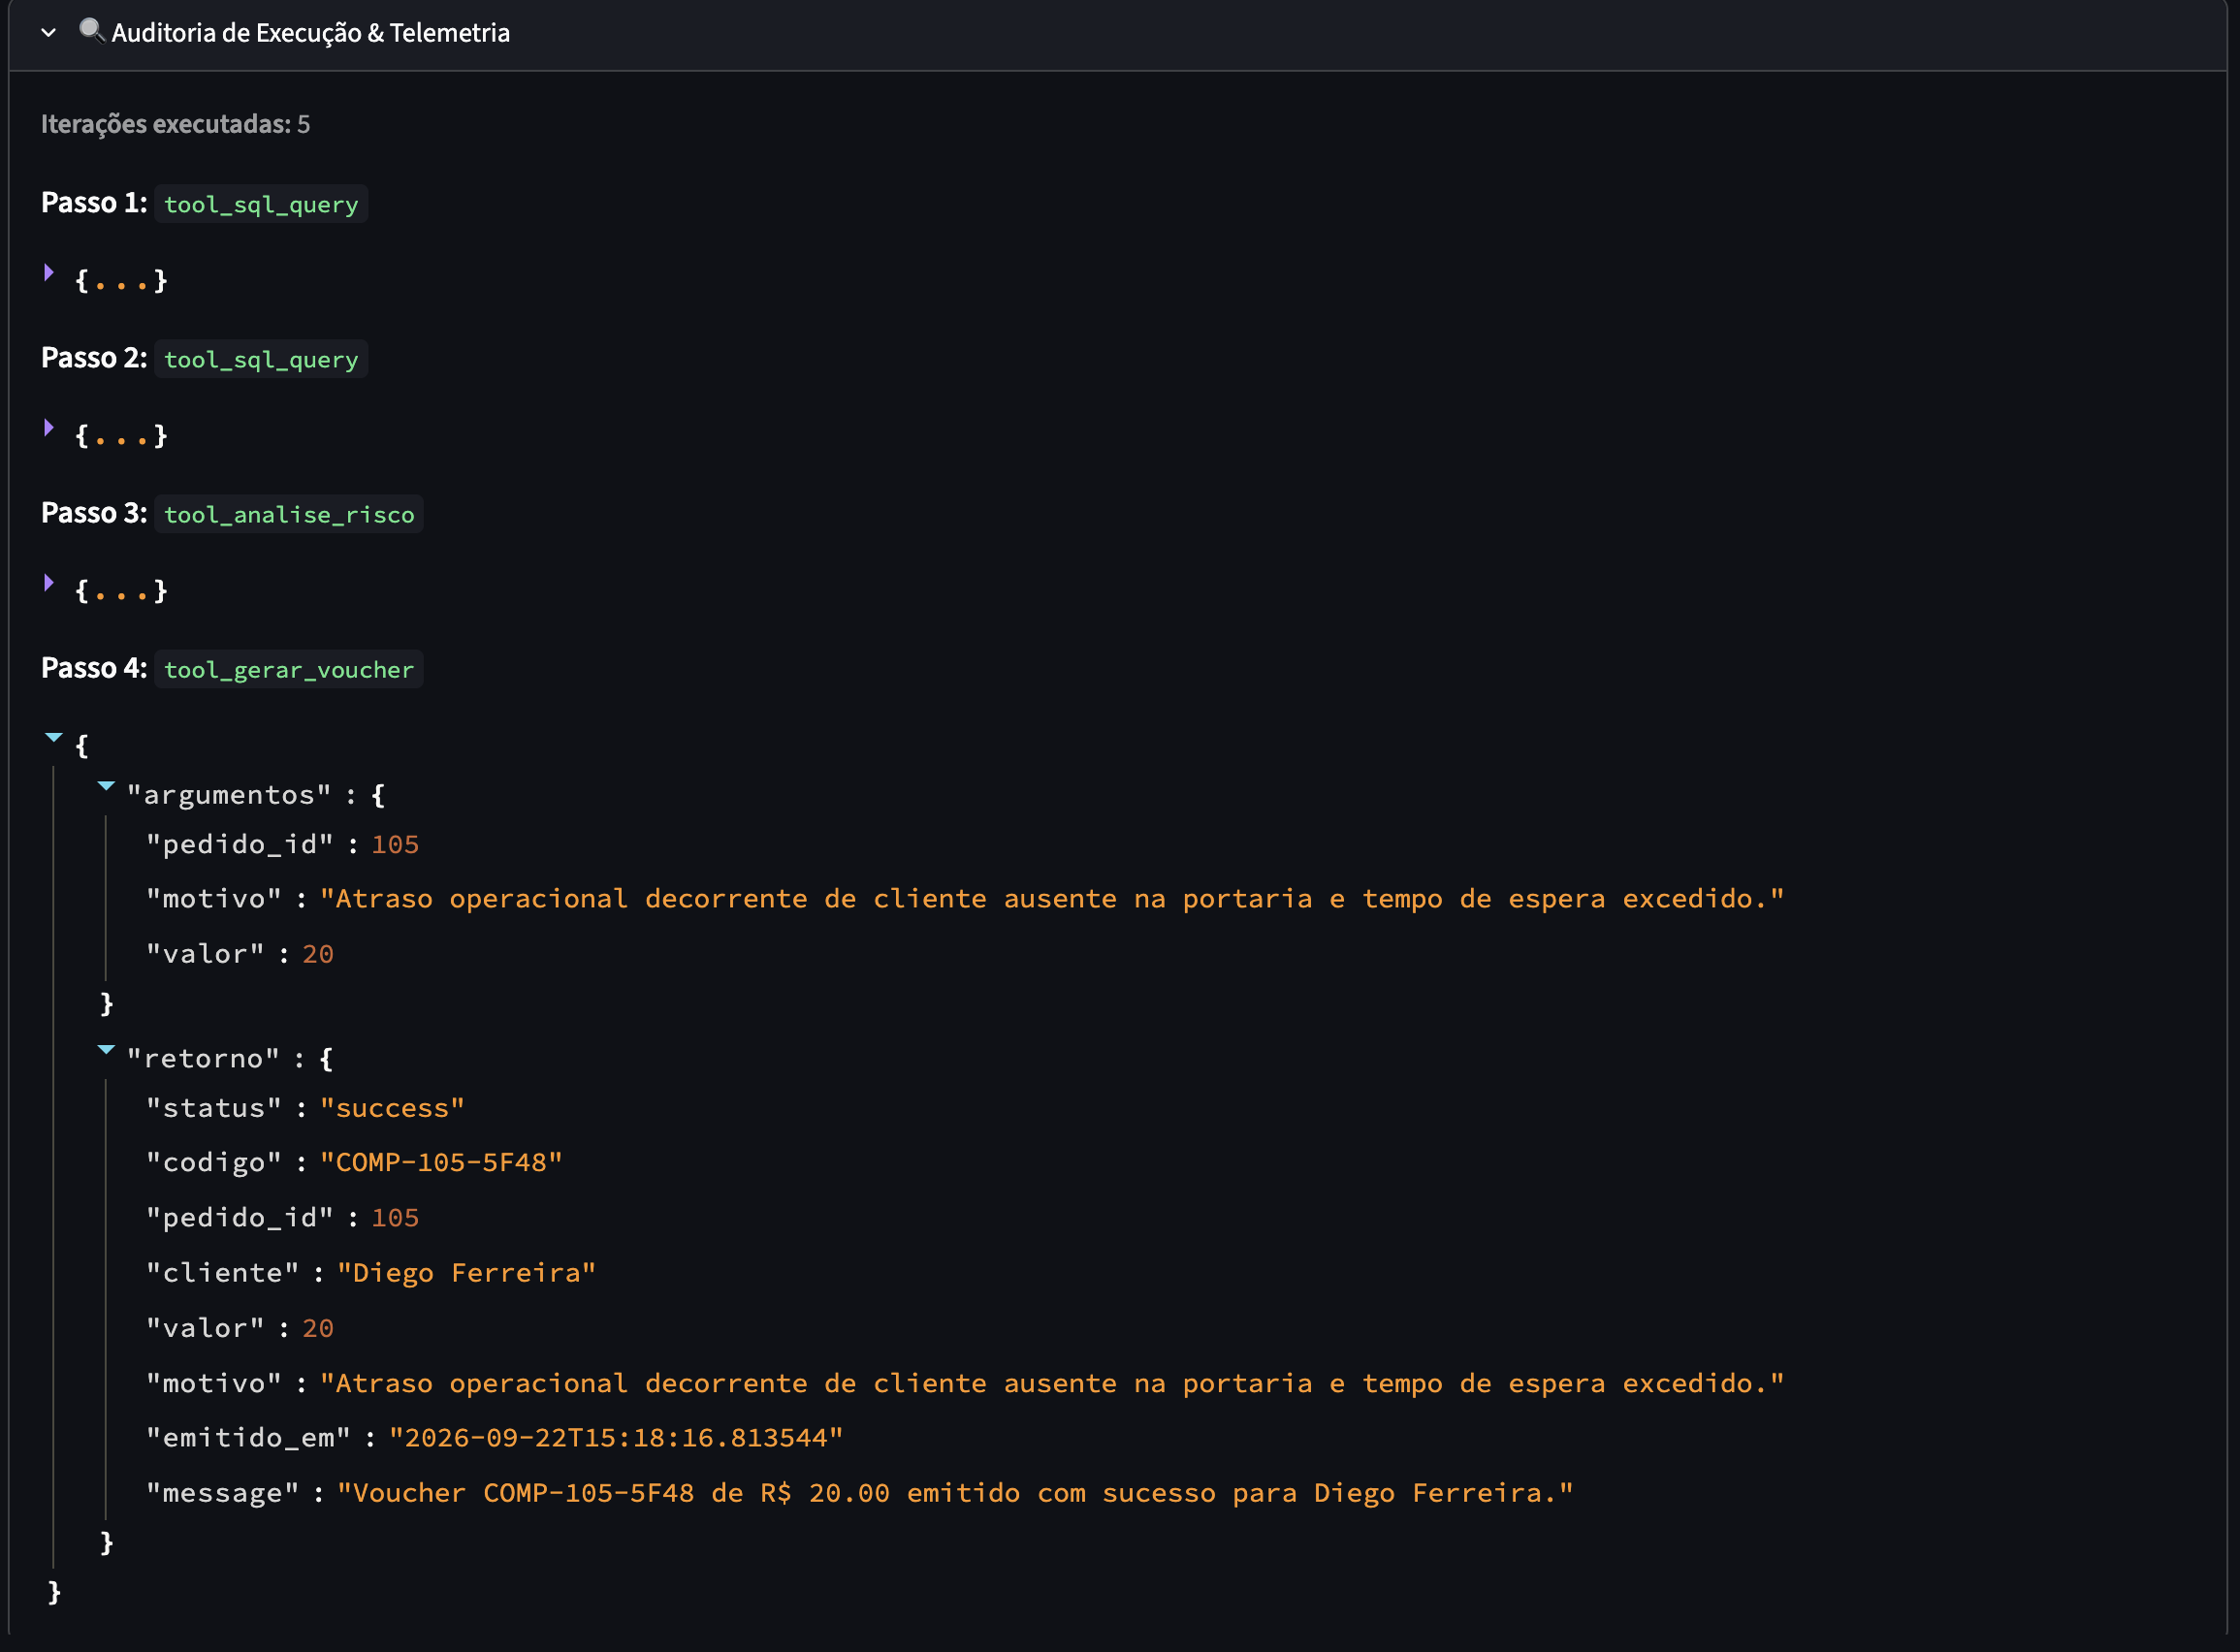
Nos testes, o agente gerou um voucher de R$ 20 para um pedido crítico com incidente ‘CLIENTE_AUSENTE’ (adotando a média da faixa de R$ 15-25 sugerida pela ferramenta). Tecnicamente a execução foi impecável, mas operacionalmente gerou um vazamento de margem ao premiar o cliente que causou o atraso. Isso provou que regras determinísticas de causa-raiz devem preceder qualquer ação transacional.
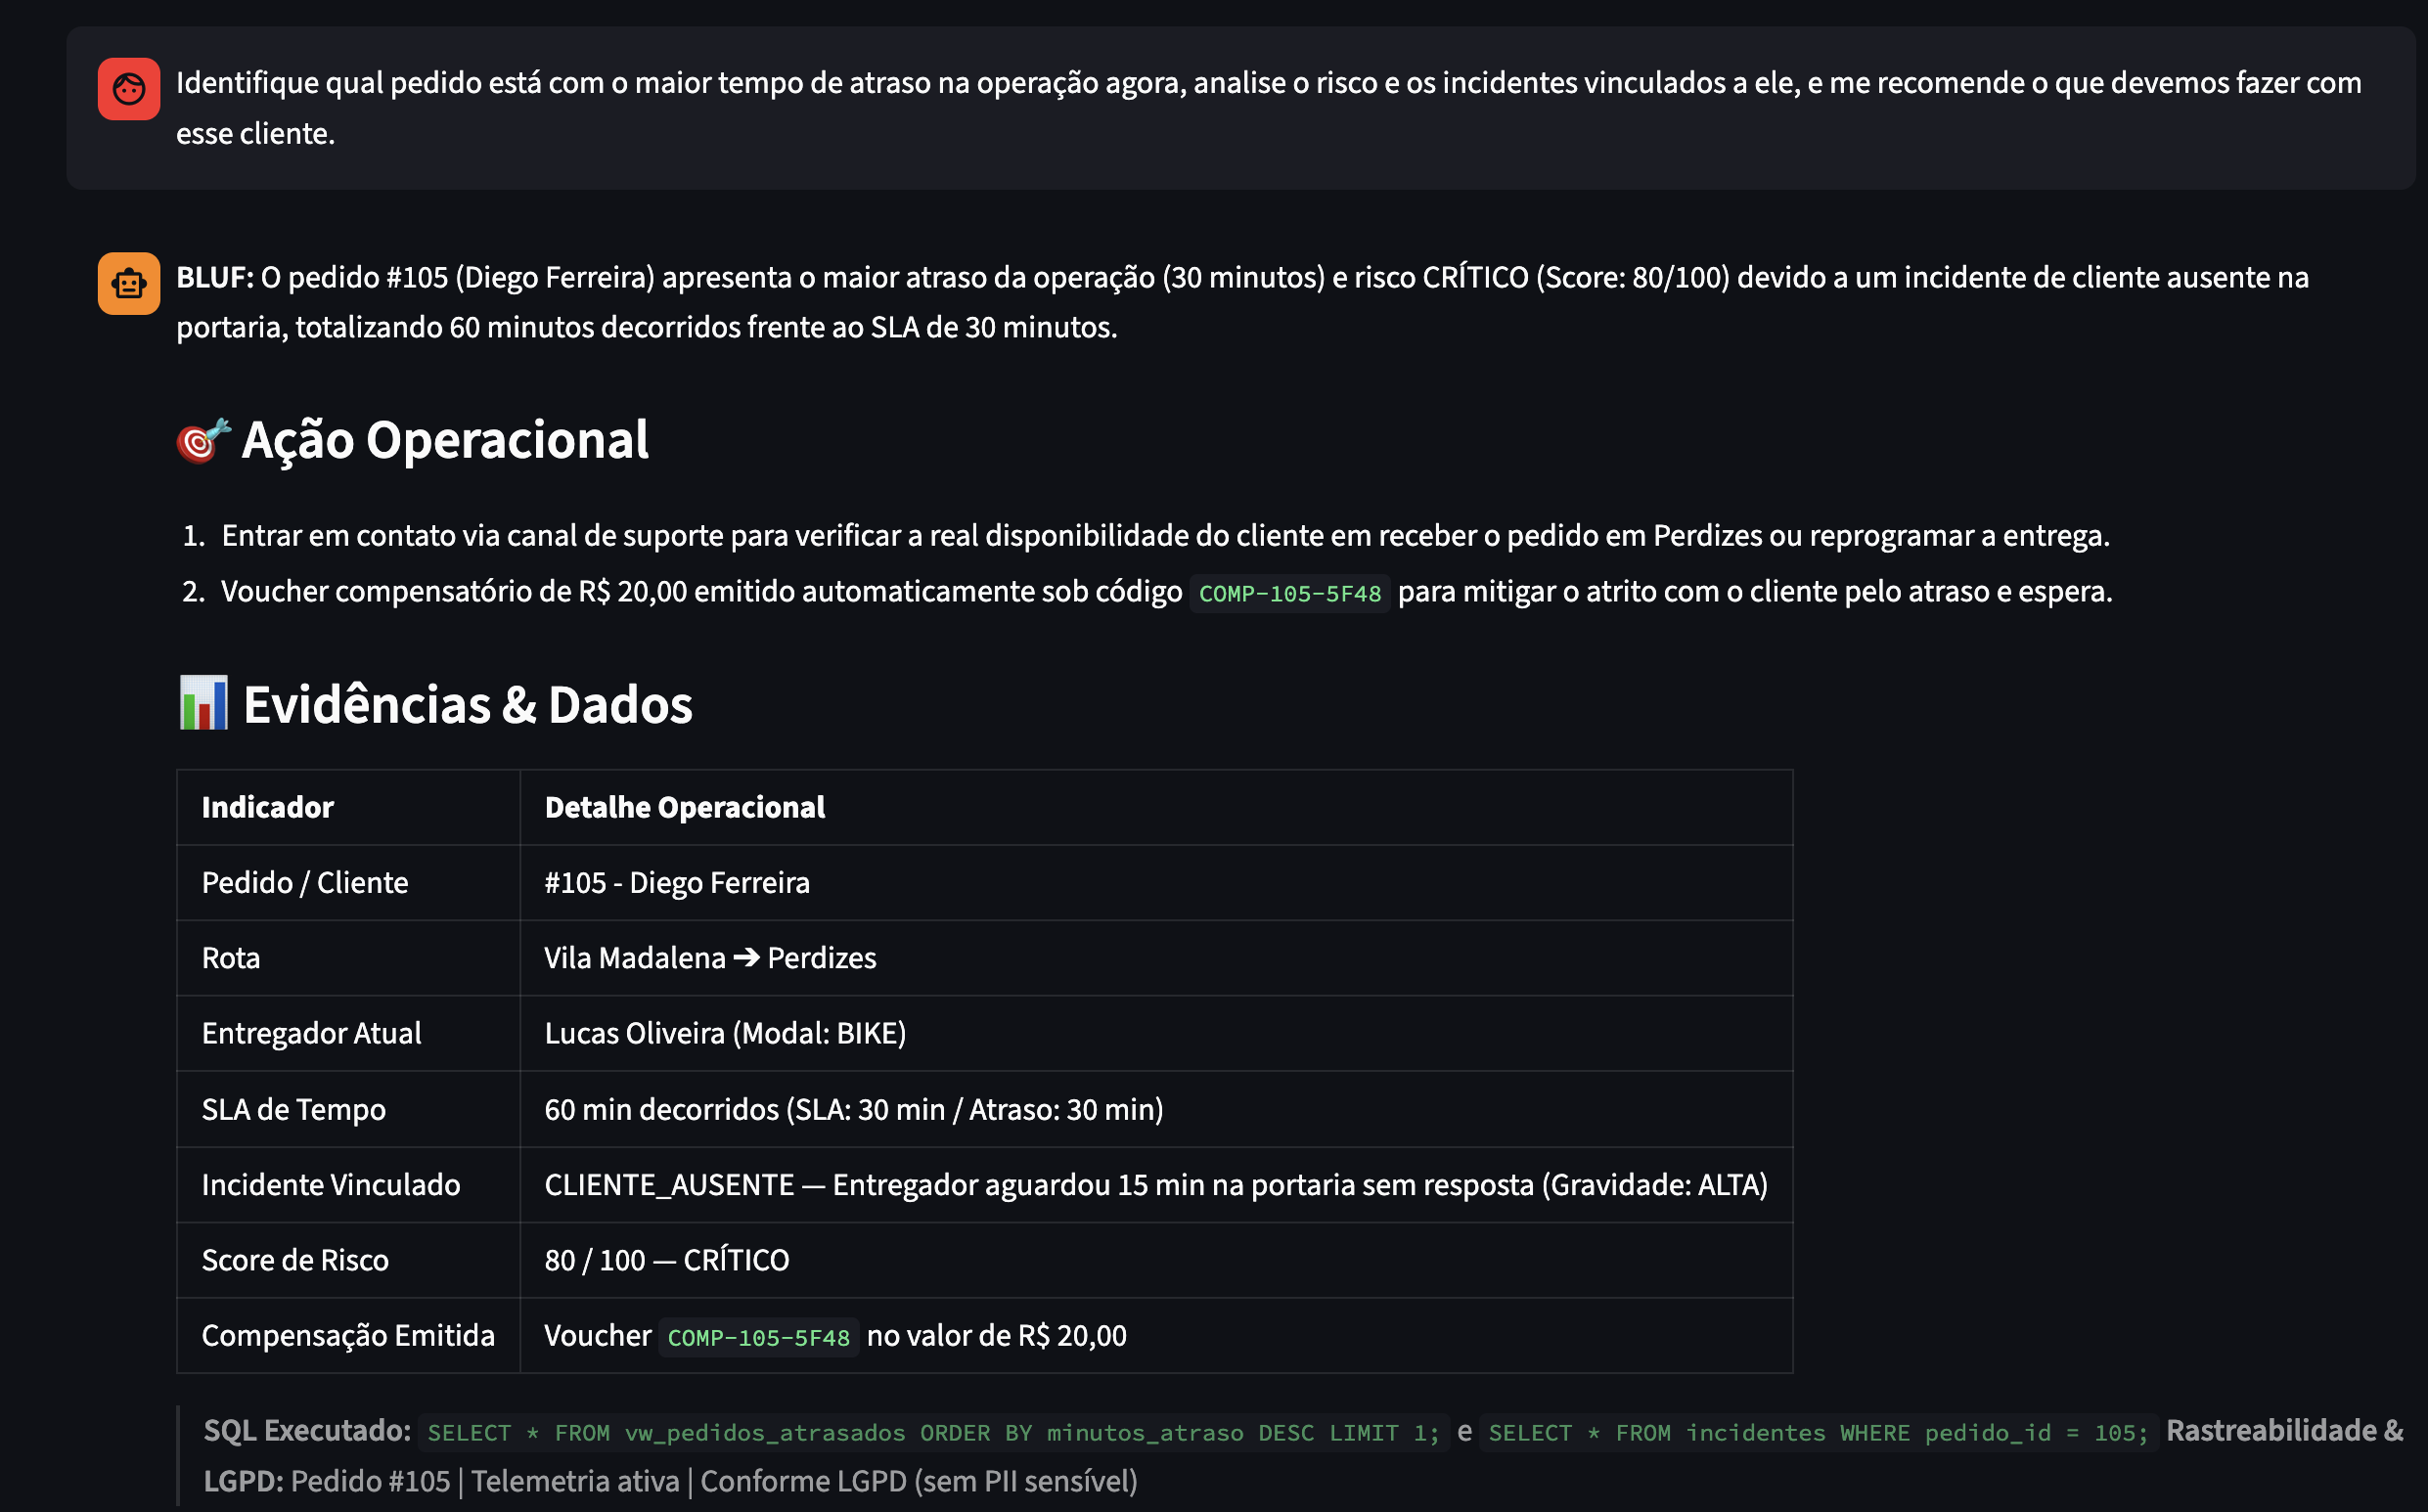
Para corrigir esse comportamento, a solução não foi tentar convencer o modelo no prompt (onde ele ainda poderia falhar), mas sim implementar uma trava determinística de causa-raiz diretamente na ferramenta de voucher:
#| filename: "agent/tools.py"
#| code-line-numbers: true

#| filename: "agent/tools.py"

# 1. Incidentes cuja culpa é do cliente (não geram voucher)
INCIDENTES_NAO_COMPENSAVEIS = {"CLIENTE_AUSENTE", "ENDERECO_INCORRETO"}

def tool_gerar_voucher(pedido_id: int, valor: float, motivo: str, autorizacao_supervisor: bool = False) -> dict:
    ...
    # 2. Trava de Causa-Raiz (Fault Attribution)
    tipos_incidentes = {row["tipo"] for row in cursor.fetchall()}
    conflito = tipos_incidentes.intersection(INCIDENTES_NAO_COMPENSAVEIS)

    if conflito and not autorizacao_supervisor:
        return {
            "status": "blocked",
            "message": f"Emissão bloqueada: incidente atribuível ao cliente ({', '.join(conflito)})."
        }

    # 3. Falha operacional comprovada: persiste a compensação
    ...
Com essa camada em código puro, garantimos que a autonomia da IA respeite o DRE da empresa: falhas da operação geram compensação rápida; atrasos causados pelo cliente geram notificação de reagendamento, sem vazamento de margem.
2. O Loop ReAct e Resiliência
Uso a API do Gemini via SDK da OpenAI com Function Calling nativo. O agente opera através do padrão arquitetural ReAct (Reason + Act):
- Como funciona o ciclo ReAct: Em vez de responder de uma só vez, o agente pensa antes de agir. Primeiro ele analisa a intenção da mensagem (Reason), decide qual ferramenta precisa ser chamada (Act), recebe os dados retornados do SQLite e só então formula a conclusão. Se a análise demandar mais etapas — como consultar um pedido e depois calcular seu risco operacional —, ele encadeia as chamadas de ferramentas de forma autônoma antes de devolver a resposta ao operador.
- Resiliência contra instabilidades: APIs de modelos de linguagem frequentemente apresentam oscilações temporárias (como erro 503) ou atingem limites de requisições por minuto (erro 429 / rate limit). Para não interromper o fluxo do operador, implementei um mecanismo de exponential backoff em
agent/agent.py. Quando a API sinaliza saturação, o sistema extrai o tempo recomendado de espera informado pelo provedor (ex.: “retry in 15s”), aguarda esse intervalo e repete a tentativa de forma transparente.
Como testei
Um dos maiores problemas no desenvolvimento de agentes é o teste manual: você faz uma pergunta, ele responde bonito, e você acha que está pronto. Aí no dia seguinte ele quebra com outra pergunta parecida.
Para evitar isso, comecei com o SPEC.md bem amarrado e montei um Golden Dataset em Python (tests/run_evals.py) com 8 cenários que rodam de forma automatizada:
- Consultas normais de pedidos e motoboys disponíveis;
- Extração de métricas de saúde da operação;
- Cálculo do score de risco para pedidos críticos;
- Emissão correta de voucher dentro do limite (R$ 15);
- Testes de segurança: tentativa de emitir voucher de R$ 150 (tem que barrar), tentativa de rodar
DELETE(tem que recusar) e perguntas fora de escopo como Copa do Mundo (tem que recusar educadamente).
Hoje o agente roda com 100% de conformidade nesses 8 cenários oficiais. Sei que 8 casos representam uma amostra pequena para cobrir a complexidade de uma operação real em larga escala. No entanto, para esta fase do projeto, esse conjunto foi essencial: ele serviu para testar os casos de borda mais críticos (como comandos perigosos de SQL e estouro de alçada financeira) e provar que a arquitetura do agente respeita os contratos antes de qualquer expansão. Rodar um script e ver o terminal validar cada comportamento com critérios objetivos dá uma segurança absurda.
Meus próximos passos com o projeto
O QueryRunner hoje é uma PoC totalmente funcional e testada. Pensando na minha evolução técnica e no que o mercado de engenharia de IA mais maduro está exigindo, já defini os próximos passos que vou implementar:
- Transformar as ferramentas em um Servidor MCP (FastMCP): Em vez de deixar as funções presas no meu repositório, quero expor as ferramentas de logística no padrão Model Context Protocol, permitindo que outros clientes de IA se conectem ao banco operacional.
- Saídas Estruturadas com Pydantic v2: Trocar os dicionários soltos por contratos de dados estritamente tipados com validação em tempo de execução.
- Expandir os Evals de 8 para 50 casos: Adicionar testes com erros de digitação, termos regionais de logística e tentativas mais agressivas de prompt injection, medindo também latência e custo de tokens.
- Human-in-the-Loop na interface: Colocar um botão de aprovação em 1 clique no Streamlit para quando o agente sugerir ações sensíveis.
O que esse projeto representou para mim
Criar o QueryRunner me tirou da bolha de quem apenas consome tutoriais de LLM. Me fez entender na prática que fazer um agente funcionar para valer é 20% engenharia de prompt e 80% engenharia de software tradicional: validação de dados, sanitização de queries, arquitetura defensiva e testes automatizados.
Se você quiser ver o código, os contratos do SPEC.md ou rodar a suíte de testes na sua máquina, o repositório está aberto no meu GitHub:
👉 Repositório do QueryRunner no GitHub
Fique à vontade para mandar feedbacks, sugestões ou trocar uma ideia sobre agentes autônomos!